
¿Qué es un LLM y cómo funciona? Deja un comentario
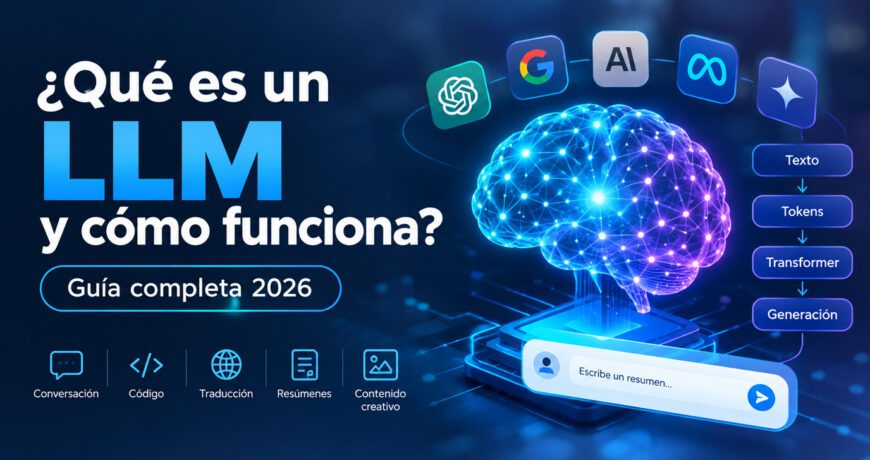
¿Qué es un LLM y cómo funciona? Guía completa 2026
El “predictor de la siguiente palabra” que cambió el mundo
El 30 de noviembre de 2022, OpenAI lanzó un chatbot. No tenía una interfaz espectacular, ni funciones revolucionarias a primera vista. Solo un cuadro de texto. Escribías una pregunta y te respondía. Eso era todo.
Pero ese aparentemente simple instrumento atrajo a más de 100 millones de usuarios en apenas dos meses, convirtiéndose en la aplicación de consumo de más rápido crecimiento de la historia hasta ese momento. Escribía poemas, programaba, traducía idiomas, explicaba conceptos complejos, redactaba correos, resumía documentos y hasta aprobaba exámenes profesionales. La gente se asombró, se asustó, debatió. Y en el centro de todo aquello había una tecnología con un nombre técnico: el LLM.
LLM son las siglas de Large Language Model, que en español se traduce como gran modelo de lenguaje o modelo extenso de lenguaje. No es solo el motor detrás de ChatGPT: también impulsa Gemini, Claude, Llama, Qwen, Mistral y prácticamente todos los asistentes conversacionales modernos.
Pero, ¿qué es exactamente un LLM? ¿De verdad “entiende” el lenguaje? ¿Por qué a veces inventa datos con total seguridad? ¿Cómo se entrena? ¿Qué implicaciones tiene para empresas, estudiantes y profesionales?
Esta guía responde a todas esas preguntas. Vamos a desmontar el concepto pieza a pieza, desde lo más básico hasta los detalles técnicos, pasando por sus aplicaciones reales, sus limitaciones y el marco regulatorio que ya está empezando a aplicarse en Europa.
¿Qué es un LLM?
Definición clara y directa
Un LLM (Large Language Model) es un sistema de inteligencia artificial basado en redes neuronales profundas, diseñado para comprender, generar y manipular lenguaje humano. Su capacidad central se puede resumir en una frase: predecir cuál es la siguiente palabra (o fragmento de palabra) más probable dado un contexto.
Parece demasiado simple. Pero cuando el modelo es lo suficientemente grande, cuando se entrena con volúmenes ingentes de texto y cuando la arquitectura es la adecuada, ese mecanismo básico da lugar a capacidades sorprendentes: mantener conversaciones coherentes, razonar sobre problemas, escribir código funcional, traducir entre idiomas, resumir documentos largos o generar contenido creativo.
Ese fenómeno se conoce como emergencia: habilidades que no están programadas explícitamente, sino que surgen como consecuencia de la escala.
LLM, IA generativa y otros términos que conviene distinguir
Es habitual confundir términos. Vamos a aclararlos:
- Inteligencia artificial (IA): el campo general que abarca cualquier sistema capaz de realizar tareas que requieren inteligencia humana.
- Machine learning (aprendizaje automático): una rama de la IA en la que los sistemas aprenden patrones a partir de datos, en lugar de ser programados explícitamente.
- Deep learning (aprendizaje profundo): una subrama del machine learning basada en redes neuronales con muchas capas.
- IA generativa: sistemas capaces de crear contenido nuevo (texto, imágenes, audio, vídeo, código).
- LLM: un tipo específico de IA generativa especializada en lenguaje.
En resumen: un LLM es un modelo de IA generativa centrado en texto. Es una pieza dentro del ecosistema más amplio de la inteligencia artificial.
Los LLM más conocidos en 2026
El ecosistema de LLM ha crecido enormemente. Estos son algunos de los modelos más relevantes:
- GPT (OpenAI): la familia detrás de ChatGPT. Modelos multimodales capaces de procesar texto, imagen y audio.
- Claude (Anthropic): enfocado en seguridad, razonamiento y contexto largo.
- Gemini (Google DeepMind): modelo multimodal nativo integrado en el ecosistema Google.
- Llama (Meta): familia de modelos abiertos que se pueden ejecutar localmente.
- Mistral (Mistral AI): modelos europeos eficientes y de alto rendimiento.
- Qwen (Alibaba): familia de modelos con versiones abiertas y comerciales.
- DeepSeek: modelos de razonamiento con buen rendimiento y bajo coste.
¿Cómo funciona un LLM? Del texto a los números
Para entender cómo funciona un LLM, hay que aceptar una idea clave: los ordenadores no entienden texto, entienden números. Todo el proceso de un LLM consiste en convertir lenguaje humano en representaciones numéricas, procesarlas y volver a convertirlas en texto.
Paso 1: tokenización
El primer paso es dividir el texto en unidades llamadas tokens. Un token puede ser una palabra completa, una parte de una palabra, un signo de puntuación o incluso un espacio. Por ejemplo, la frase “Los LLM son fascinantes” podría dividirse en algo como: [“Los”, ” LL”, “M”, ” son”, ” fasc”, “inantes”].
El conjunto de tokens que un modelo puede manejar se llama vocabulario, y suele tener entre 50.000 y 200.000 entradas. Cada token se asocia a un número entero (su ID).
Paso 2: embeddings
Cada token se convierte en un vector de números reales, llamado embedding. Estos vectores capturan el significado del token en un espacio matemático de cientos o miles de dimensiones. Palabras con significados similares tienden a tener vectores cercanos.
Por ejemplo, los vectores de “rey” y “reina” estarán más cerca entre sí que los de “rey” y “plátano”. Esta representación numérica es lo que permite al modelo operar con el lenguaje.
Paso 3: atención (el corazón del Transformer)
Aquí entra en juego el mecanismo más importante: la atención. Cada token “mira” a todos los demás tokens del contexto y decide cuáles son relevantes para él. Por ejemplo, en la frase “El gato persiguió al ratón porque tenía hambre”, el modelo debe determinar que “tenía hambre” se refiere al gato, no al ratón.
La atención permite al modelo capturar relaciones a larga distancia dentro del texto, algo que arquitecturas anteriores no lograban bien.
Paso 4: capas del Transformer
Un LLM moderno apila muchas capas de Transformer (decenas o incluso cientos). Cada capa procesa la información, la transforma y la pasa a la siguiente. A medida que la información avanza por las capas, el modelo construye representaciones cada vez más abstractas y ricas del texto.
Paso 5: generación autorregresiva
Una vez procesado el contexto, el modelo calcula la probabilidad de cada posible token siguiente. Selecciona uno (según una estrategia determinada) y lo añade al texto. Luego repite el proceso, ahora con el nuevo token incluido en el contexto.
Este proceso se llama generación autorregresiva. Es la razón por la que los LLM escriben “palabra a palabra”.
Paso 6: decodificación y parámetros de muestreo
La forma en que el modelo elige el siguiente token no es siempre la misma. Existen parámetros como:
- Temperatura: controla la aleatoriedad. Valores bajos generan respuestas más predecibles; valores altos, más creativas.
- Top-k: limita la selección a los k tokens más probables.
- Top-p (nucleus sampling): selecciona entre los tokens cuya probabilidad acumulada supera un umbral.
Estos parámetros permiten ajustar el comportamiento del modelo según el uso.
La arquitectura Transformer: el pilar de los LLM
El gran salto de los LLM llegó en 2017 con el paper “Attention is All You Need“, de un equipo de Google. Ese trabajo introdujo la arquitectura Transformer, que sustituyó a las redes recurrentes (RNN) y convolucionales (CNN) como base de los modelos de lenguaje.
¿Qué hace especial al Transformer?
- Procesamiento paralelo: a diferencia de las RNN, que procesan el texto secuencialmente, el Transformer puede procesar todos los tokens a la vez. Esto acelera enormemente el entrenamiento.
- Atención multi-cabeza: el mecanismo de atención se aplica varias veces en paralelo, capturando diferentes tipos de relaciones.
- Escalabilidad: la arquitectura permite apilar muchas capas y aumentar el número de parámetros sin perder estabilidad.
- Versatilidad: funciona bien con texto, imágenes, audio y otras modalidades.
Componentes clave del Transformer
- Self-attention: cada token atiende a los demás del contexto.
- Feed-forward networks: transformaciones no lineales aplicadas a cada posición.
- Normalización y conexiones residuales: estabilizan el entrenamiento y permiten apilar capas profundas.
- Codificación posicional: aporta información sobre el orden de los tokens, ya que el Transformer por sí solo no tiene noción de secuencia.
Variantes: encoder, decoder y encoder-decoder
Existen tres configuraciones principales:
- Encoder-only: como BERT. Útil para clasificación, análisis de sentimiento y búsqueda semántica.
- Decoder-only: como GPT. Es la base de la mayoría de LLM generativos actuales.
- Encoder-decoder: como T5. Utilizado en traducción y resumen.
.
Cómo se entrena un LLM
Entrenar un LLM es un proceso complejo que requiere enormes recursos computacionales, datos masivos y varias fases bien diferenciadas.
Fase 1: preentrenamiento
El modelo se entrena con cantidades gigantescas de texto: libros, artículos, webs, código, foros. El objetivo es aprender a predecir el siguiente token. No se le dice explícitamente qué es correcto o incorrecto; simplemente aprende patrones estadísticos del lenguaje.
Esta fase puede consumir miles de GPU durante semanas o meses y costar millones de dólares.
Fase 2: ajuste fino supervisado (SFT)
Después del preentrenamiento, el modelo se afina con ejemplos de instrucciones y respuestas deseadas. Aquí se le enseña a seguir instrucciones, mantener un tono adecuado y evitar respuestas peligrosas o dañinas.
Fase 3: aprendizaje por refuerzo con retroalimentación humana (RLHF)
Humanos evalúan las respuestas del modelo y le dan feedback. Con esa información, se entrena un modelo de recompensa que guía al LLM hacia respuestas más útiles, seguras y alineadas con los valores humanos.
Fase 4: optimizaciones y despliegue
Antes de ponerlo en producción, se aplican técnicas de compresión, cuantización y optimización para reducir el coste de inferencia. También se implementan sistemas de filtrado y moderación.
El papel de los datos
La calidad de los datos es determinante. Un modelo entrenado con datos sesgados, tóxicos o desactualizados reflejará esos problemas. Por eso la curación de datos, la transparencia y la diversidad son temas centrales en el desarrollo responsable de LLM.
Capacidades de un LLM
Generación de texto
Es la función más conocida. Los LLM escriben artículos, correos, guiones, ensayos, cuentos, poemas y más, adaptándose al tono y estilo solicitados.
Comprensión y respuesta a preguntas
Pueden responder preguntas sobre un texto dado, resumirlo, extraer información clave o explicar conceptos complejos.
Traducción
Traducen entre decenas de idiomas con una calidad que, en muchos casos, supera a los sistemas tradicionales.
Resumen
Condensan documentos largos en versiones más breves sin perder la información esencial.
Generación de código
Escriben, completan, explican y depuran código en múltiples lenguajes de programación.
Razonamiento
Los modelos más avanzados pueden seguir cadenas de razonamiento, resolver problemas matemáticos y realizar inferencias lógicas.
Conversación
Mantienen diálogos coherentes, recuerdan el contexto y se adaptan al usuario.
Aplicaciones reales de los LLM
En empresas
- Atención al cliente automatizada.
- Generación de informes y resúmenes.
- Análisis de documentos legales y contratos.
- Automatización de tareas administrativas.
- Asistentes internos para empleados.
En educación
- Tutores personalizados.
- Generación de ejercicios y materiales.
- Explicaciones adaptadas al nivel del estudiante.
- Apoyo a la investigación.
En sanidad
- Resumen de historiales clínicos.
- Apoyo al diagnóstico.
- Generación de informes.
- Búsqueda de información médica.
En programación
- Autocompletado de código.
- Detección de errores.
- Documentación automática.
- Refactorización.
En creación de contenido
- Redacción de artículos y posts.
- Guiones para vídeo y podcast.
- Descripciones de producto.
- Traducción y localización.
En investigación
- Revisión de literatura.
- Generación de hipótesis.
- Análisis de datos.
- Redacción de papers.
Limitaciones y riesgos de los LLM
Alucinaciones
Los LLM pueden generar información falsa pero convincente. Esto ocurre porque generan texto basándose en probabilidades, no en una base de datos verificada.
Sesgos
Los datos de entrenamiento contienen sesgos históricos y sociales. El modelo los reproduce y, en ocasiones, los amplifica.
Falta de razonamiento causal
Los LLM identifican correlaciones, pero no comprenden relaciones causales profundas. Pueden fallar en tareas que requieren sentido común o comprensión del mundo físico.
Contexto limitado
Aunque las ventanas de contexto han crecido mucho (algunos modelos manejan millones de tokens), siguen teniendo límites. Información fuera del contexto no está disponible.
Coste computacional
Entrenar y ejecutar LLM consume enormes cantidades de energía y recursos. Esto plantea desafíos de sostenibilidad y acceso.
Riesgos de seguridad
Los LLM pueden ser utilizados para generar desinformación, deepfakes, phishing o contenido dañino.
Propiedad intelectual
El uso de datos protegidos por derechos de autor en el entrenamiento es objeto de debate legal en múltiples jurisdicciones.
Cómo usar un LLM de forma responsable
Verifica la información
No confíes ciegamente en las respuestas. Contrasta datos, fechas y afirmaciones con fuentes fiables.
Revisa el contenido
Antes de publicar o usar profesionalmente, revisa y edita lo que ha generado el modelo.
Protege datos sensibles
No introduzcas información confidencial en herramientas públicas.
Cita el uso de IA
Si usas LLM para crear contenido, sé transparente al respecto.
Usa la IA como apoyo
Es una herramienta, no un sustituto del criterio humano.
El AI Act y la regulación de los LLM en Europa
El Reglamento Europeo de Inteligencia Artificial (AI Act) es el primer marco regulatorio integral del mundo para la IA. Entró en vigor en agosto de 2024 y sus disposiciones se están aplicando de forma escalonada. Algunas obligaciones comienzan a aplicarse a partir de agosto de 2026.
Modelos de propósito general (GPAI)
El AI Act introduce obligaciones específicas para los modelos de IA de propósito general (GPAI), categoría que incluye a los LLM. Estas obligaciones incluyen:
- Documentación técnica del modelo.
- Información sobre los datos de entrenamiento.
- Respeto a los derechos de autor.
- Evaluaciones de riesgo y mitigación.
- Transparencia sobre capacidades y limitaciones.
Modelos con riesgo sistémico
Los modelos más potentes, considerados de “riesgo sistémico”, tienen obligaciones adicionales: evaluaciones más estrictas, notificación de incidentes y ciberseguridad reforzada.
Implicaciones para empresas
Las empresas que desarrollan o despliegan LLM en Europa deben adaptarse a este marco. La transparencia, la documentación y la evaluación de riesgos se convierten en requisitos legales.
Puedes consultar el texto oficial del reglamento en EUR-Lex.
El futuro de los LLM
Modelos más pequeños y eficientes
La tendencia no es solo hacer modelos más grandes, sino más eficientes. Modelos pequeños, entrenados para tareas específicas, pueden ofrecer resultados excelentes con menos recursos.
Multimodalidad nativa
Los LLM del futuro integrarán texto, imagen, audio y vídeo de forma natural.
Agentes autónomos
Los LLM evolucionarán hacia agentes capaces de ejecutar tareas complejas, usar herramientas y tomar decisiones.
Razonamiento mejorado
Se están desarrollando técnicas para mejorar la capacidad de razonamiento lógico y matemático de los modelos.
Integración en el día a día
Los LLM se integrarán en sistemas operativos, navegadores, aplicaciones de oficina y herramientas profesionales.
Preguntas frecuentes sobre los LLM
¿Qué es un LLM?
Un gran modelo de lenguaje: un sistema de IA basado en redes neuronales profundas, entrenado con enormes volúmenes de texto para comprender y generar lenguaje humano.
¿Cómo funciona un LLM?
Convierte texto en tokens, los transforma en vectores numéricos, los procesa con capas de Transformer y genera la siguiente palabra de forma autorregresiva.
¿Qué es un token?
Una unidad de texto: puede ser una palabra, parte de una palabra o un signo de puntuación.
¿Qué es el Transformer?
La arquitectura de red neuronal que sustituyó a las RNN y CNN, basada en mecanismos de atención y procesamiento paralelo. Es la base de los LLM modernos.
¿Qué es la atención?
Un mecanismo que permite a cada token del texto fijarse en los demás para determinar cuáles son relevantes para su significado.
¿Por qué los LLM alucinan?
Porque generan texto basándose en probabilidades, no en una base de datos verificada. Pueden producir información falsa pero convincente.
¿Cuántos parámetros tiene un LLM?
Varía mucho: desde cientos de millones hasta billones. Los modelos más grandes suelen tener más capacidad, pero también más coste.
¿Puedo ejecutar un LLM en mi ordenador?
Sí, existen modelos abiertos como Llama o Mistral que se pueden ejecutar localmente, aunque requieren hardware potente.
¿Son legales los LLM?
Sí, pero su desarrollo y uso están sujetos a regulaciones como el AI Act europeo. El debate sobre derechos de autor sigue abierto.
¿Reemplazarán los LLM a los humanos?
Son herramientas de apoyo. Automatizan tareas, pero no sustituyen el criterio, la creatividad ni la responsabilidad humana.
Entender los LLM es entender el presente
Los LLM han pasado de ser un tema de investigación especializada a convertirse en una tecnología cotidiana. Están en los asistentes que usamos, en las herramientas que empleamos para trabajar y en los servicios que consumimos.
Entender qué son, cómo funcionan y qué límites tienen no es solo un ejercicio técnico: es una forma de participar informada en el debate sobre el futuro de la tecnología.
No se trata de mitificarlos ni de temerlos. Se trata de conocerlos, usarlos con criterio y exigir que se desarrollen de forma responsable, transparente y alineada con los valores humanos.
Porque los LLM no son magia. Son matemáticas, datos y diseño. Y entenderlo es el primer paso para aprovecharlos bien
